
확인 시점: 2026-09-24 (가격과 기능은 바뀔 수 있어서 바뀌면 이 글을 수정하겠습니다.)
결론부터 말씀드리겠습니다.
이번 주 나온 두 모델 중 가격만 보면 그록 4.7이 더 저렴하고, 클로드 오퍼스 5.5는 이전 모델(오퍼스 5)보다 가격이 내려간 모델입니다.
API로 모델을 골라 써야 하는 개발자분들이 읽으시면 좋은 글입니다.
저는 2026년 9월 24일에 두 회사의 공식 문서를 직접 열어서 가격과 사양을 대조했습니다.
오늘은 이번 주 나온 AI 모델 두 개의 뜻과 차이, 가격을 알아보도록 하겠습니다.
새 모델이 나올 때마다 가격이 얼마인지, 이전 모델과 무엇이 다른지 헷갈려서 한 번 정리해 두려고 합니다.
그래서 이번 주 나온 두 모델을 공식 문서 기준으로 표로 만들어 보았습니다.
이번 주에 어떤 모델이 나왔나요?
제가 확인한 것은 이 두 개입니다.
- 클로드 오퍼스 5.5(Claude Opus 5.5): 2026년 9월 22일 출시. 공식 문서에 출시일이 적혀 있습니다.
- 그록 4.7(Grok 4.7): 2026년 9월 21일 출시로 보도되었습니다. 공식 문서 페이지에는 출시일이 없어서 보도로 확인했습니다.
여기서 이름의 뜻부터 짚고 넘어가겠습니다.
오퍼스(Opus)는 Anthropic(앤트로픽) 클로드 모델의 등급 이름이고, 5.5는 세대 번호입니다.
공식 문서 설명으로는 오퍼스 5.5가 "오래 걸리는 코딩과 업무용 에이전트 작업"을 위한 모델입니다.
그록 4.7은 xAI 쪽 모델이고, 공식 문서 설명은 "코딩, 에이전트 작업, 지식 업무용 최신 모델"입니다.
API에서 부르는 이름은 각각 claude-opus-5-5, grok-4.7입니다.
두 모델은 무엇이 다른가요?
공식 문서 기준으로 표로 정리해 보았습니다.
▼ 두 모델의 공식 문서 사양 비교 (2026-09-24 확인)
| 항목 | Claude Opus 5.5 | Grok 4.7 |
|---|---|---|
| 컨텍스트 윈도우(context window) | 100만 토큰 | 50만 토큰 |
| 입력 | 텍스트, 이미지 | 텍스트, 이미지 |
| 출력 | 텍스트 | 텍스트 |
| 생각하는 방식 | 적응형, 끌 수 없음 | 노력 수준 low/medium/high/xhigh (기본 high) |
| 최대 출력 | 12만 8천 토큰 | 공식 페이지에서 확인 불가 |
여기서 눈여겨볼 점은 오퍼스 5.5는 생각(thinking)을 끌 수 없다는 것입니다.
기존에 오퍼스 5로 만든 코드가 있다면 공식 문서의 마이그레이션 안내에서 바뀐 점 4가지를 한 번 체크해보시는 것이 좋을 것 같습니다.
(생각 끄기 불가, 도구 사용 강제 시 오류, 생각 블록이 모델에 묶임, 이전 컴퓨터 사용 도구 미지원)
가격은 얼마인가요?
먼저 공식 문서에 나온 가격 화면입니다.
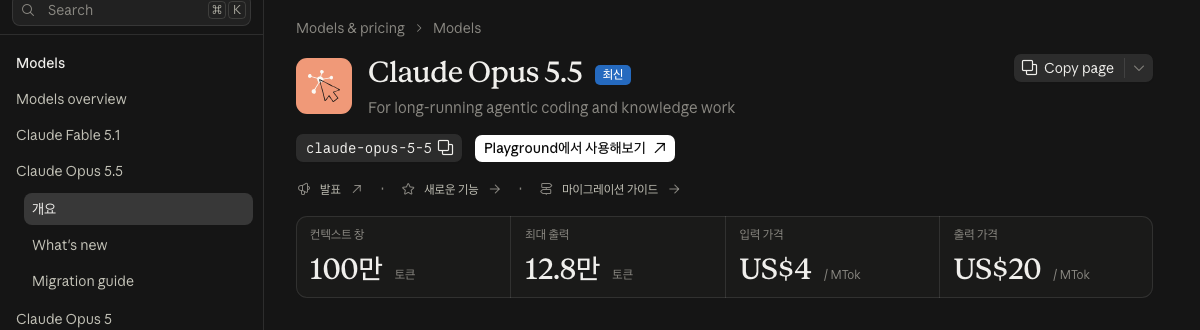
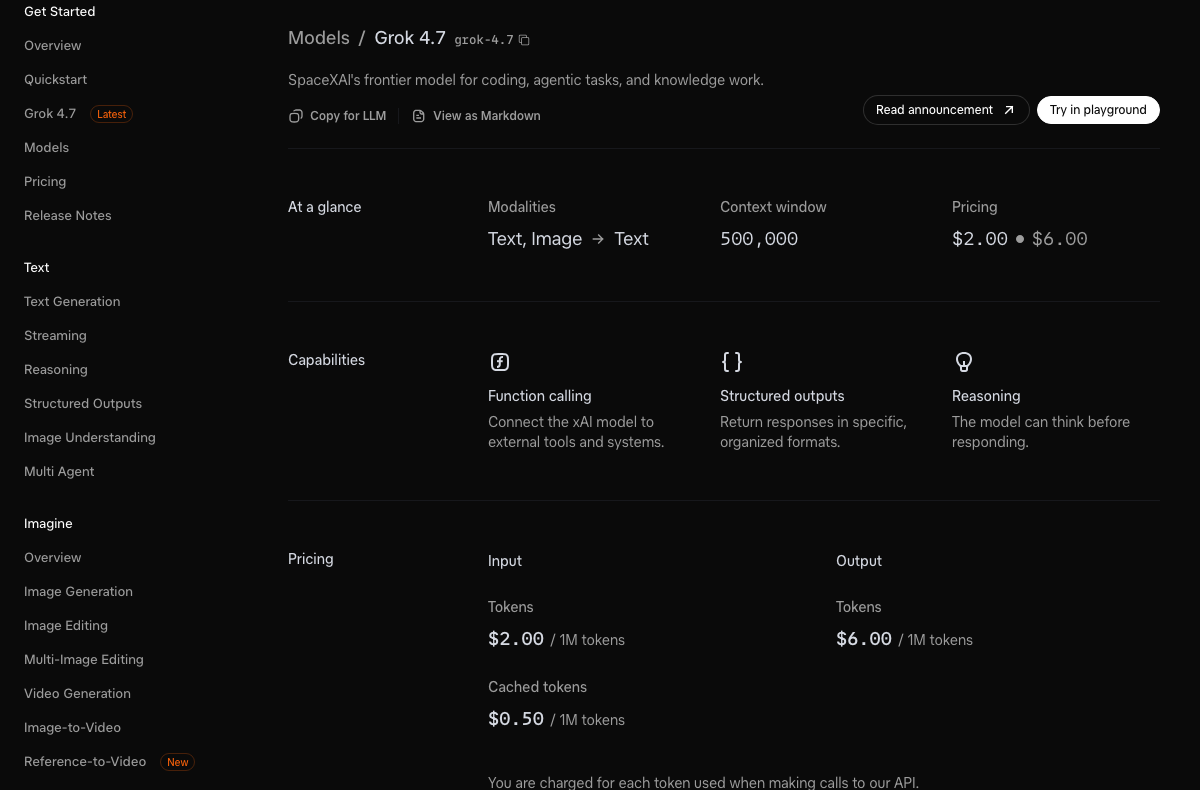
이 가격을 토큰(token)당으로 정리하면 아래와 같습니다. 단위는 100만 토큰(MTok)입니다.
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| Claude Opus 5 (previous) | $5 | $25 | $0.50 |
| Claude Sonnet 5 | $2 | $10 | - |
| Claude Fable 5.1 | $10 | $50 | - |
| Grok 4.7 (프롬프트 20만 토큰 이하) | $2 | $6 | $0.50 |
| Grok 4.7 (프롬프트 20만 토큰 초과) | $4 | $12 | $1 |
오퍼스 5.5의 이전 모델 가격은 앤트로픽 발표문에 적힌 값입니다.
앤트로픽은 "일반적인 작업에서 오퍼스 5보다 비용이 40% 적다"고 밝혔는데, 이것은 회사가 밝힌 수치이고 제가 재현한 값이 아닙니다.
그록 4.7은 한 가지 주의할 점이 있습니다.
제3자 집계 사이트에는 입력 $1.60, 출력 $4.80으로 적힌 곳이 있었는데, 공식 문서는 $2, $6이었습니다.
그래서 이 글에서는 공식 문서 값만 썼습니다.
같은 작업을 시키면 비용이 얼마나 나올까요?
그럼 계산을 한 번 해보겠습니다.
입력 100만 토큰, 출력 20만 토큰을 쓰는 작업이라고 가정하겠습니다.
(직접 돌린 값이 아니라 위 공식 가격으로 계산한 값입니다.)
▼ 입력 100만 + 출력 20만 토큰 가정 시 예상 비용
| 모델 | 계산 | 예상 비용 |
|---|---|---|
| Grok 4.7 (요청당 20만 토큰 이하) | 2 + 0.2 × 6 | $3.20 |
| Claude Sonnet 5 | 2 + 0.2 × 10 | $4.00 |
| Claude Opus 5.5 | 4 + 0.2 × 20 | $8.00 |
| Claude Opus 5 | 5 + 0.2 × 25 | $10.00 |
| Claude Fable 5.1 | 10 + 0.2 × 50 | $20.00 |
계산해 보면 같은 조건에서 오퍼스 5.5가 오퍼스 5보다 20% 저렴하다는 것을 확인할 수 있습니다.
다만 이 표에는 함정이 있습니다.
모델마다 토큰을 세는 방식이 달라서 같은 글도 토큰 수가 다르게 나오고, 생각에 쓰는 토큰도 출력으로 과금됩니다.
그래서 실제 비용은 이 표와 다를 수 있습니다.
직접 돌려보니 어땠나요?
저는 같은 프롬프트를 두 모델에 한 번씩 넣어 보았습니다.
프롬프트는 "파이썬으로 문자열의 괄호 (), [], {} 짝이 맞는지 검사하는 함수를 작성하고, 테스트 케이스 5개를 함께 보여주세요."였습니다.
환경은 Claude Code CLI(claude -p)이고, 도구는 끄고 effort는 기본값으로 실행했습니다. 실행일은 2026-09-24입니다.
▼ 같은 프롬프트를 1회씩 실행한 결과 (Claude Code CLI 출력 값)
| 모델 | 출력 토큰 | 생각(thinking) 토큰 | 걸린 시간 |
|---|---|---|---|
| Claude Opus 5.5 | 988 | 21 | 약 10.6초 |
| Claude Sonnet 5 | 804 | 0 | 약 9.2초 |
한 번씩만 돌린 결과라서 우열을 말할 수 있는 수치는 아닙니다.
다만 이 정도 간단한 문제에서는 오퍼스 5.5가 생각 토큰을 거의 쓰지 않았다는 점이 눈에 띄었습니다.
Claude Code는 실행할 때 시스템 프롬프트가 함께 들어가기 때문에, CLI가 보여주는 총비용은 위의 계산표와 그대로 비교할 수 없습니다.
그래서 이 글에서는 비용 대신 출력 토큰과 시간만 적었습니다.
그럼 두 모델이 써 준 코드도 직접 실행해 보았습니다.
각각 파일로 저장해서 python3로 돌렸고, 테스트 케이스 5개가 모두 PASS로 나왔습니다.
▼ 두 모델이 작성한 함수의 실행 결과 (직접 실행, 5개 모두 통과)
| 모델 | 통과한 테스트 | 눈에 띈 차이 |
|---|---|---|
| Claude Opus 5.5 | 5 / 5 | 한글 설명 주석, 빈 문자열 케이스 포함, 예상 출력과 시간·공간 복잡도 설명까지 덧붙임 |
| Claude Sonnet 5 | 5 / 5 | 코드가 더 짧고, 괄호 외 문자가 섞인 케이스 포함, "코드를 실행해 보지는 않았다"고 스스로 밝힘 |
핵심 알고리즘은 두 모델 모두 스택(stack)을 쓰는 같은 방식이었습니다.
이렇게 쉬운 문제에서는 결과의 정확도 차이를 느끼기 어려웠습니다.
차이는 답변을 얼마나 풀어서 설명해 주느냐에서 났습니다.
Opus 5.5가 출력 토큰을 더 쓴 것도 이 설명 때문으로 보입니다.
그록 4.7은 제 환경에 API 키가 없어서 이번에는 돌려보지 못했습니다.
어려운 문제에서의 차이는 다음에 더 다뤄보도록 하겠습니다.
그래서 어떤 모델을 고르면 될까요?
상황별로 정리하면 이렇습니다.
- 비용이 가장 중요한 작업: 공식 가격 기준으로는 그록 4.7이나 소넷 5가 유리합니다.
- 긴 문서나 큰 코드베이스를 한 번에 넣어야 하는 작업: 컨텍스트 윈도우가 100만 토큰인 오퍼스 5.5가 맞습니다.
- 오퍼스 5를 이미 쓰고 있는 경우: 가격은 내려갔지만 위에서 말씀드린 바뀐 점 4가지를 먼저 확인하시기 바랍니다.
다음 시간에는 클로드 코드로 트렌드 수집기를 만든 과정을 알아보도록 하겠습니다.
지금까지 읽어주셔서 감사합니다.
지금까지 이번 주 나온 AI 모델의 뜻과 차이, 가격을 알아보았습니다.